Warum reicht klassisches SEO-Reporting für KI-Antworten nicht mehr?
Klassisches SEO-Reporting misst Rankings, Impressionen und Klicks. Bei Suchanfragen mit KI-Antwort erklären diese Zahlen nur noch einen Teil dessen, was passiert: Ein Inhalt kann in der Antwort verarbeitet werden, ohne dass daraus ein Klick entsteht.
Die Größenordnung ist inzwischen gut dokumentiert. Das Pew Research Center hat das Browsing-Verhalten von 900 US-Erwachsenen im März 2025 ausgewertet: Erschien eine KI-Zusammenfassung, klickten Nutzer in 8 % der Besuche auf ein klassisches Ergebnis, ohne Zusammenfassung in 15 %. Auf Links innerhalb der Zusammenfassung klickten sie in rund 1 % der Besuche. Ahrefs kommt in einer Auswertung von 300.000 Keywords (Daten Dezember 2025) auf eine um 58 % niedrigere Klickrate für das erstplatzierte Ergebnis, wenn eine AI Overview erscheint – im Vorjahr waren es 34,5 %.
Beide Studien zeigen Zusammenhänge, keinen sauber isolierten Kausaleffekt. Die Richtung ist aber eindeutig: Ein stabiles Ranking garantiert keine stabilen Besuche mehr.
In SEO-Projekten haben wir uns lange daran gewöhnt, dass „oben stehen“ und „besucht werden“ ungefähr dasselbe bedeuten. Für Suchanfragen mit KI-Antwort stimmt diese Gleichung nicht mehr. Ein Reporting, das nur Klicks zählt, meldet dann einen Rückgang – ohne sagen zu können, ob die Marke unsichtbar geworden ist oder nur anders sichtbar.
Was lässt sich an KI-Sichtbarkeit überhaupt messen?
KI-Sichtbarkeit lässt sich heute aus drei Datenquellen erheben, die unterschiedlich belastbar sind: Plattformdaten, Stichproben aus einem Prompt-Set und die Wirkung auf der eigenen Website. Keine Quelle deckt alles ab – zusammen ergeben sie ein brauchbares Bild.
Plattformdaten: was Google und Microsoft selbst berichten
Google hat im Juni 2026 eigene Berichte für generative KI in die Search Console aufgenommen; seit dem 31. August 2026 stehen sie weltweit zur Verfügung. Sie zeigen, wie oft Seiten in AI Overviews, im AI Mode und in KI-Funktionen von Discover erscheinen – aufgeschlüsselt nach Seite, Land, Gerät und Datum. Klicks und Suchanfragen enthält der Bericht nicht. Erscheinen zwei Ergebnisse derselben Website in einer KI-Antwort, zählt das im Diagramm als eine Impression.
Microsoft bietet in den Bing Webmaster Tools seit Februar 2026 den Bericht „AI Performance“ als Public Preview an. Er zeigt, wie oft Inhalte in Antworten von Copilot, in KI-Zusammenfassungen von Bing und bei ausgewählten Partnern als Quelle zitiert werden, welche Seiten zitiert werden und über welche Grounding Queries das geschieht. Grounding Queries sind die Suchbegriffe, die das KI-System intern formuliert, um Quellen für eine Antwort zu finden. Der Bericht misst Zitierhäufigkeit, nicht Position oder Prominenz in der Antwort.
Plattformdaten sind die belastbarste Quelle, weil sie echte Nutzung abbilden. Ihre Grenze: Sie decken nur die Systeme des jeweiligen Anbieters ab. Für ChatGPT, Claude oder Perplexity gibt es bislang keine vergleichbaren Berichte.
Stichproben: was ein festes Prompt-Set zeigt
Für alle anderen Systeme bleibt die Stichprobe: ein festes Set von Fragen, das regelmäßig in mehreren KI-Systemen abgefragt und ausgewertet wird – manuell oder mit spezialisierten Monitoring-Tools. Gemessen wird, ob die eigene Marke genannt, ob eigene Inhalte als Quelle zitiert und ob die Marke empfohlen wird.
Wie vorsichtig man dabei sein muss, zeigt eine Studie von SparkToro und Gumshoe.ai (Januar 2026): Rund 600 Freiwillige stellten zwölf identische Prompts knapp 3.000 Mal an ChatGPT, Claude und Googles KI. Die Wahrscheinlichkeit, zweimal dieselbe Markenliste zu erhalten, lag unter 1 zu 100; dieselbe Reihenfolge noch deutlich seltener. Stabiler war dagegen, wie häufig eine Marke über viele Durchläufe vorkam.
KI-Antworten sind keine Rangliste, sondern Stichproben. Messbar ist nicht die Position, sondern wie oft Sie vorkommen – und was danach passiert.
Wirkung: was auf der eigenen Website ankommt
Die dritte Quelle misst nicht Sichtbarkeit, sondern ihre Folgen. Google Analytics 4 führt seit dem 13. Mai 2026 einen eigenen Standardkanal „AI Assistant“ für Besuche von erkannten KI-Assistenten wie ChatGPT, Gemini oder Claude. Die Umstellung wirkt nicht rückwirkend, ältere Daten bleiben unter „Referral“.
Vollständig ist auch dieser Kanal nicht. Die mobilen Apps von ChatGPT öffnen Links häufig so, dass der Referrer verloren geht; solche Besuche erscheinen in GA4 als „Direct“. Klicks aus AI Overviews und AI Mode laufen als organische Google-Besuche ein und lassen sich dort nicht separat ausweisen. Gemessene KI-Besuche sind deshalb eine Untergrenze, keine Gesamtzahl.
Welche Kennzahl gehört zu welcher Stufe des Meusel Visibility Framework?
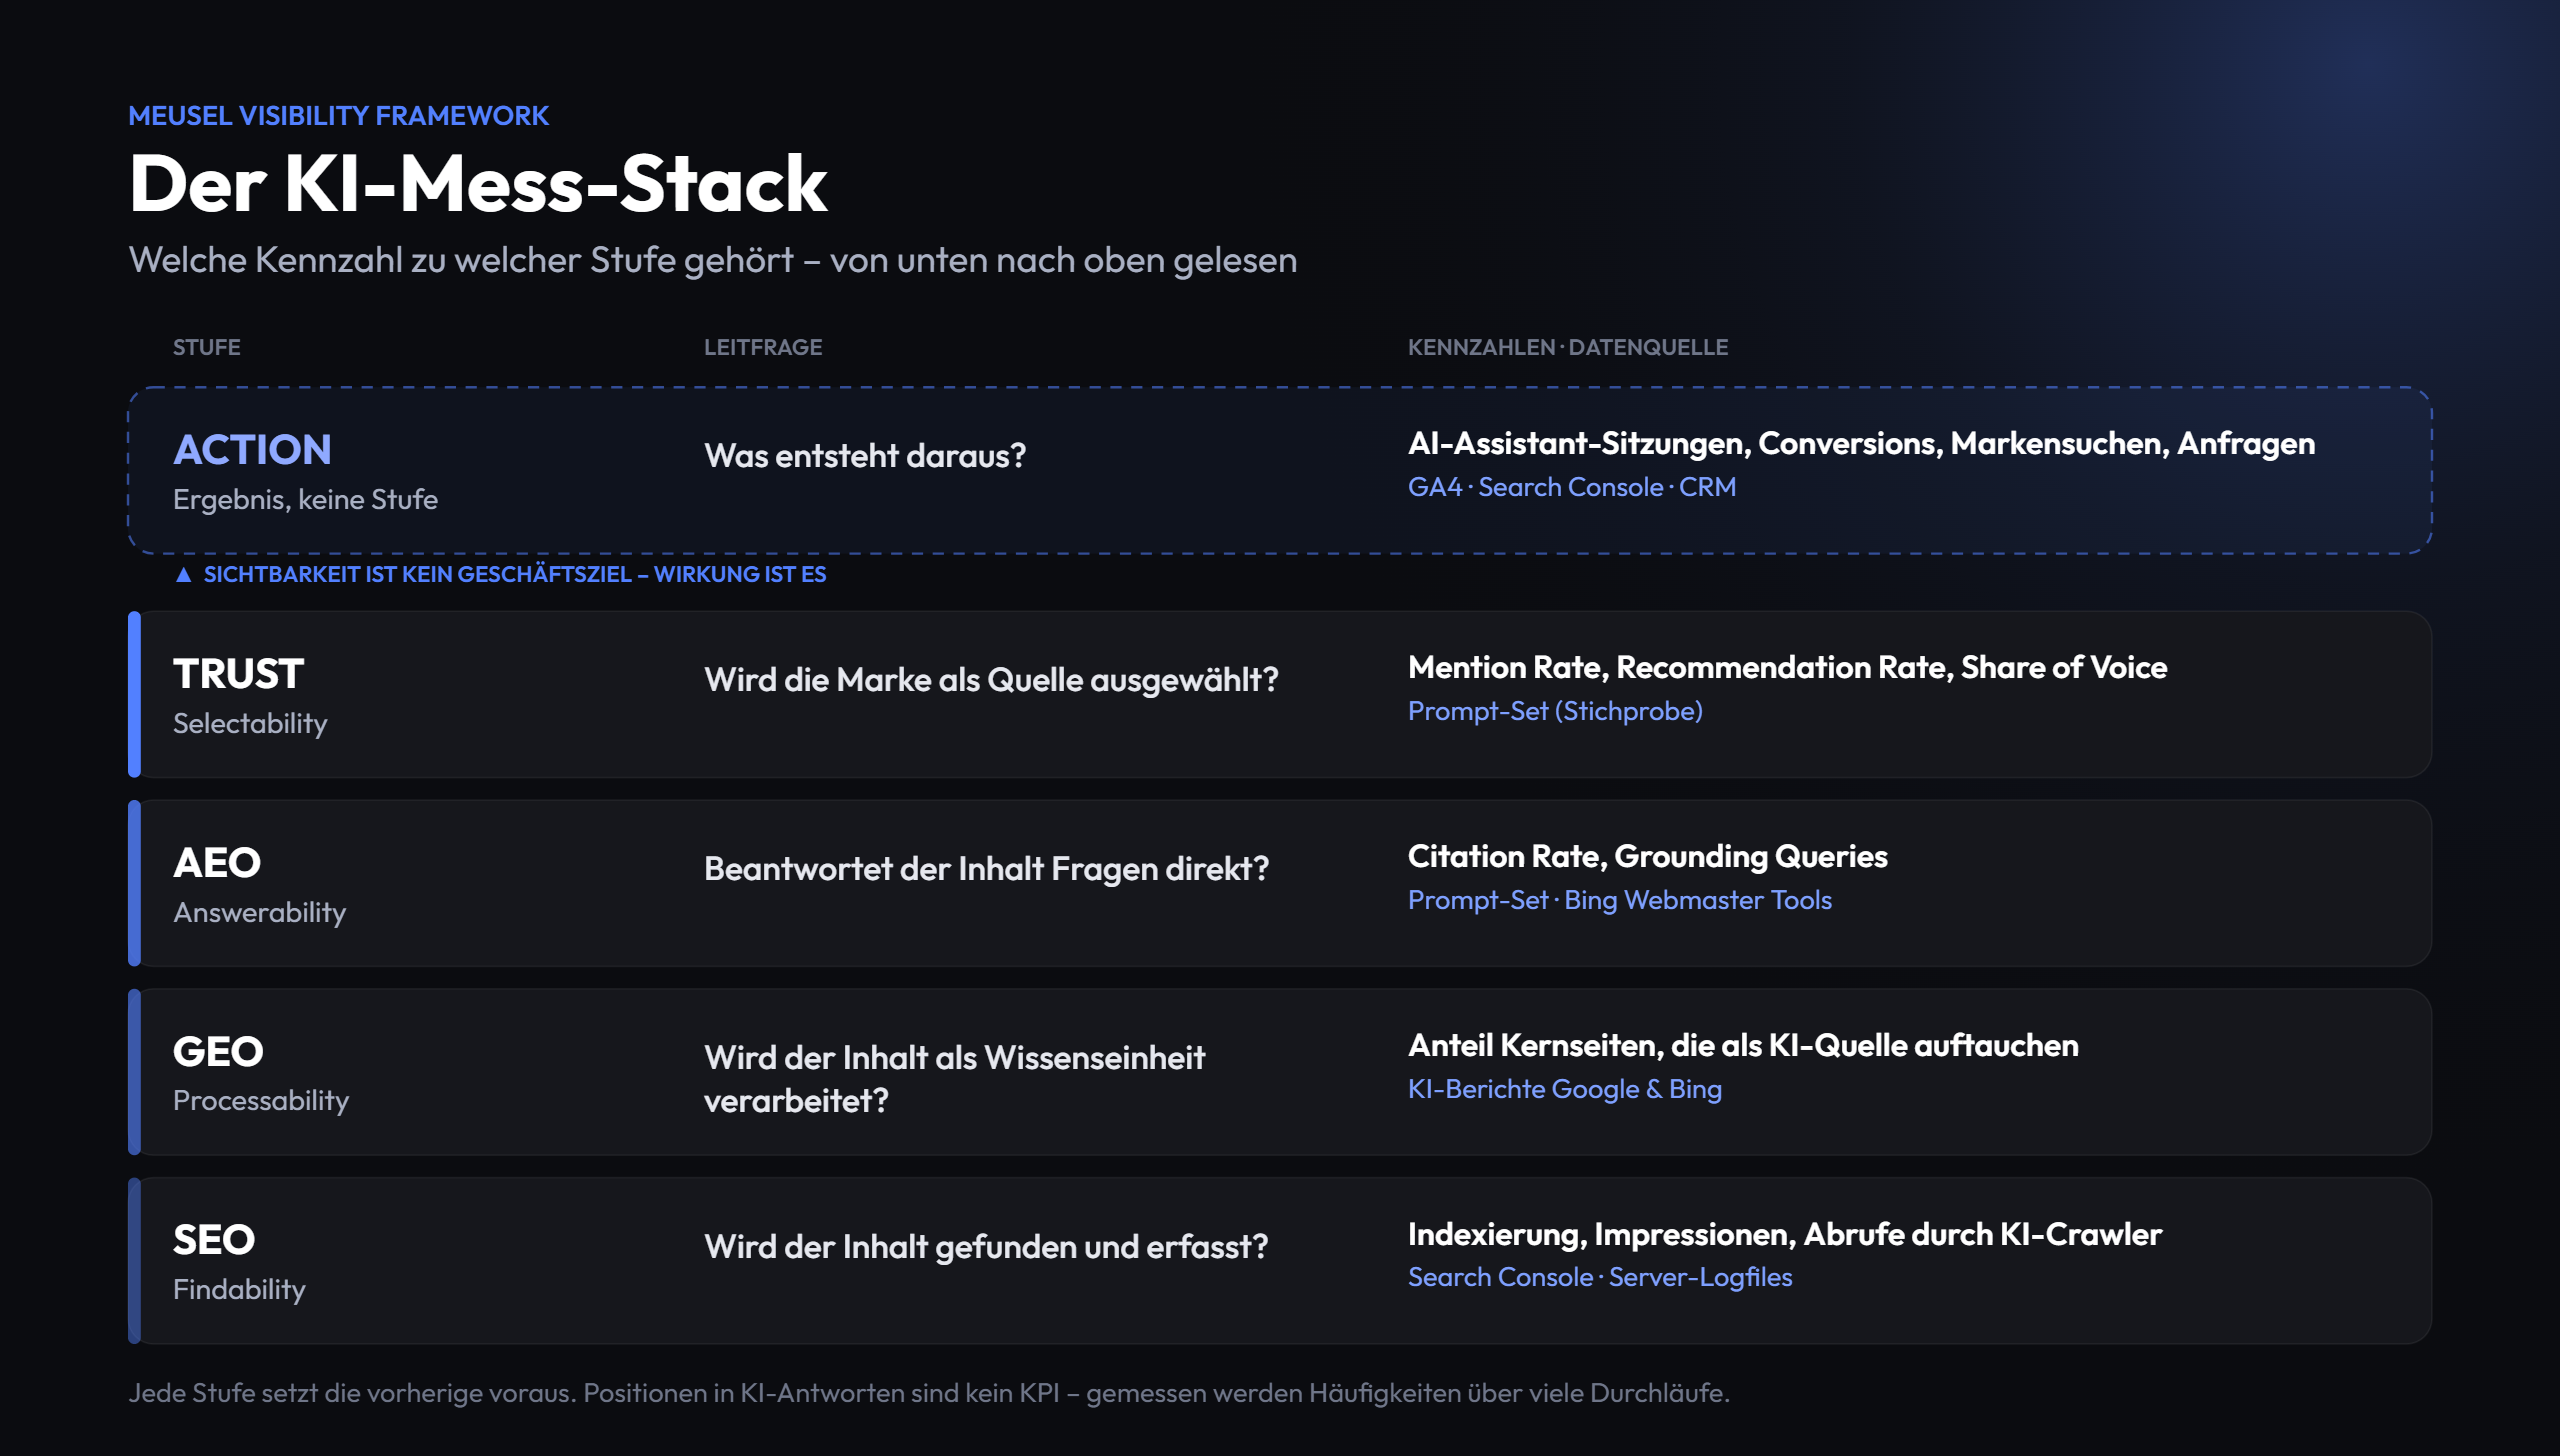
Ein belastbares KI-Reporting ordnet jeder Stufe des Meusel Visibility Framework eine eigene Leitfrage und Kennzahl zu. So wird sichtbar, auf welcher Stufe ein Inhalt hängen bleibt – statt nur festzustellen, dass „die KI-Sichtbarkeit sinkt“.
Das Framework liest sich von unten nach oben; jede Stufe setzt die vorherige voraus: Gefunden zu werden ist nicht dasselbe wie verstanden, beantwortet oder ausgewählt zu werden. Die folgende Zuordnung ist unser Arbeitsmodell für Reportings, keine Branchennorm.
SEO – Findability: Wird der Inhalt gefunden, gecrawlt und eingeordnet? Kennzahlen: indexierte Kernseiten, klassische Impressionen und Klicks in der Search Console, Zugriffe von Such- und KI-Crawlern in den Server-Logfiles. Ohne diese Basis erscheinen alle folgenden Werte zufällig.
In den Logfiles lohnt sich eine Unterscheidung, die viele Reportings auslassen: Crawler, die Inhalte für das Training von Modellen sammeln, sind etwas anderes als Abrufe, die ein KI-System im Moment einer Nutzerfrage auslöst – etwa über Such- und Nutzer-Agenten wie OAI-SearchBot, ChatGPT-User, Perplexity-User oder Claude-SearchBot. Für die Sichtbarkeit in Antworten sind vor allem die zweiten relevant. Blockiert die robots.txt sie, kann ein Inhalt nicht als Quelle erscheinen, egal wie gut er ist.
GEO – Processability: Kann ein KI-System den Inhalt als eigenständige Wissenseinheit verarbeiten? Direkt messbar ist das nicht. Ein brauchbarer Näherungswert ist der Anteil der indexierten Kernseiten, die in den KI-Berichten von Google oder Bing überhaupt als Quelle auftauchen. GEO verwenden wir hier im engen Sinn; in der Branche wird der Begriff teils als Sammelbegriff für KI-Sichtbarkeit gebraucht.
AEO – Answerability: Liefert der Inhalt eine direkte, belastbare Antwort? Kennzahl: die Citation Rate im Prompt-Set – bei wie vielen Fragen eigene Inhalte als Beleg herangezogen werden. Ergänzend zeigen die Grounding Queries aus Bing, zu welchen Fragen ein Inhalt bereits als Antwortquelle dient.
Trust – Selectability: Wird der Inhalt, wird die Marke als Quelle ausgewählt? Kennzahlen: Mention Rate und Recommendation Rate im Prompt-Set sowie der Anteil an allen Nennungen im Wettbewerbsumfeld (Share of Voice). Trust entscheidet am Ende – aufgebaut wird er auf jeder Ebene.
Action – Wirkung: Was entsteht daraus? Kennzahlen: Sitzungen und Conversions im Kanal „AI Assistant“, die Entwicklung von Markensuchen in der Search Console und Anfragen, in denen Kunden KI-Systeme als Informationsquelle angeben. Action ist keine fünfte Stufe, sondern das Ergebnis: Sichtbarkeit ist kein Geschäftsziel. Wirkung ist das Geschäftsziel.
Wichtig ist die saubere Trennung von Nennung, Zitat und Empfehlung. Eine Mention bedeutet, dass die Marke genannt wird. Eine Citation bedeutet, dass ein Inhalt als Beleg herangezogen wird. Eine Recommendation bedeutet, dass die Marke als Lösung empfohlen wird. Wer die drei in einer Zahl zusammenfasst, verliert genau die Information, die für Maßnahmen gebraucht wird.
Warum sind Positionen in KI-Antworten kein belastbarer KPI?
Positionen in KI-Antworten sind kein belastbarer KPI, weil sich Reihenfolge und Zusammensetzung von Antworten bei identischer Frage fast jedes Mal ändern. Wer „Platz 2 in ChatGPT“ berichtet, beschreibt eine einzelne Ziehung, keinen Zustand.
Die SparkToro-Studie zeigt das deutlich: Dieselbe Frage lieferte unterschiedliche Marken, unterschiedliche Reihenfolgen und unterschiedlich lange Listen. Eine Auswertung von Ahrefs aus dem Dezember 2025 kam zu einem verwandten Ergebnis auf anderer Ebene: AI Mode und AI Overviews zitieren für dieselbe Anfrage in 87 % der Fälle unterschiedliche Quellen.
Daraus folgen zwei Regeln für das Reporting. Erstens: Häufigkeiten statt Positionen – also „in 42 von 60 Durchläufen genannt“ statt „auf Platz 3“. Zweitens: ausreichend viele Durchläufe pro Frage. In der Diskussion um die Studie werden 60 bis 100 Durchläufe pro Prompt als Orientierung genannt; eine feste Untergrenze für jede Branche lässt sich daraus nicht ableiten.
Es gibt eine Einschränkung, die Mut macht: In engen Märkten sind Antworten stabiler. Eine Replikation der Methode für Hotelanfragen im Google AI Mode fand, dass dasselbe Hotel in rund der Hälfte der Durchläufe an erster Stelle stand. Je begrenzter das Angebot und je klarer die Frage, desto eher lässt sich Sichtbarkeit auch in kleineren Stichproben verfolgen.
Ein einzelner Screenshot aus ChatGPT ist deshalb ungefähr so aussagekräftig wie ein einzelnes Wetterfoto für das Klima eines Jahres.
Warum 20 Durchläufe selten reichen: eine einfache Rechnung
Warum so viele Durchläufe nötig sind, zeigt eine einfache Faustrechnung aus der Statistik. Wird eine Marke in der Hälfte der Durchläufe genannt, liegt die Unsicherheit dieser Quote (95-%-Intervall, Normalnäherung) bei 20 Durchläufen bei etwa ±22 Prozentpunkten, bei 60 Durchläufen bei etwa ±13 und bei 100 Durchläufen bei etwa ±10 Prozentpunkten.
Praktisch heißt das: Ein Anstieg der Mention Rate von 45 % auf 55 % ist bei 20 Durchläufen nicht von Zufall zu unterscheiden. Bei 100 Durchläufen wird er zumindest plausibel. Wer kleine Stichproben monatlich vergleicht, berichtet deshalb häufig Bewegungen, die es nicht gibt. Die Rechnung ist eine Vereinfachung – KI-Antworten sind keine perfekt unabhängigen Zufallsziehungen –, aber sie zeigt die Größenordnung des Problems.
Es gibt noch einen zweiten Hebel neben mehr Durchläufen: Fragen bündeln. Die SparkToro-Auswertung deutet darauf hin, dass KI-Systeme eher die Absicht hinter einer Frage erfassen als ihren Wortlaut. Es ist deshalb sinnvoll, mehrere Formulierungen derselben Absicht zu einem Cluster zusammenzufassen und die Quote pro Cluster zu berichten statt pro Einzelfrage.
Praxisbeispiel: Wie sieht ein Monatsreporting für KI-Sichtbarkeit aus?
Ein praxistaugliches KI-Reporting passt auf eine Seite, folgt den Stufen des Meusel Visibility Framework und zeigt Trends statt Einzelwerte. Das folgende Beispiel beschreibt den Aufbau für einen mittelständischen B2B-Anbieter; es enthält bewusst keine Ergebniszahlen, weil diese je Markt stark schwanken.
Schritt 1 – Prompt-Set festlegen. 30 Fragen aus echten Kundengesprächen, Vertriebs-E-Mails und der Search Console, gegliedert in drei Cluster: Problem („Wie reduziere ich …?“), Vergleich („Was ist besser: … oder …?“) und Anbieter („Welche Anbieter für … gibt es in Deutschland?“). Das Set bleibt mindestens ein Quartal unverändert, sonst sind Trends nicht vergleichbar.
Zwei Details entscheiden über die Qualität des Sets. Erstens: Markenfragen („Was bietet Firma X?“) und markenfreie Fragen („Welche Anbieter für … gibt es?“) gehören in getrennte Auswertungen. Markenfragen zeigen, wie korrekt eine KI über das Unternehmen spricht; nur markenfreie Fragen zeigen, ob es von sich aus genannt wird. Zweitens: Jede Frage bekommt zwei bis drei Formulierungsvarianten, die im selben Cluster ausgewertet werden.
Schritt 2 – Stichprobe planen. Jede Frage wird in drei KI-Systemen regelmäßig abgefragt, sodass pro Frage und System im Quartal rund 60 Durchläufe zusammenkommen. Ausgewertet wird pro Durchlauf: genannt ja/nein, als Quelle zitiert ja/nein, empfohlen ja/nein, genannte Wettbewerber.
Damit die Durchläufe vergleichbar bleiben, wird das Setting festgehalten: Sprache und Land, ob mit oder ohne Anmeldung abgefragt wird, ob die Websuche des Systems aktiv ist, Datum und – soweit sichtbar – das verwendete Modell. Personalisierte Konten mit langer Chat-Historie verzerren die Ergebnisse (mehr dazu im Knowledge Case Query Memory Effect); für das Monitoring sind neutrale Konten oder die Abfrage über ein Tool die sauberere Wahl.
Schritt 3 – Plattformdaten ergänzen. Aus der Search Console kommen die KI-Impressionen je Seite, aus den Bing Webmaster Tools die zitierten Seiten und Grounding Queries. Grounding Queries, die zu keiner Frage im Prompt-Set passen, sind Kandidaten für die nächste Version des Sets.
Schritt 4 – Wirkung erfassen. In GA4 werden der Kanal „AI Assistant“ und die Direct-Einstiege auf Fachseiten beobachtet. Im Anfrageformular fragt ein optionales Feld „Wie sind Sie auf uns aufmerksam geworden?“ auch KI-Assistenten ab – eine einfache Selbstauskunft, die keine Technik ersetzen kann.
Schritt 5 – Auf einer Seite verdichten. Fünf Zeilen, eine pro Stufe plus Wirkung, jeweils mit Kennzahl, Trend gegenüber Vorquartal und einem Satz Einordnung. Eine Zeile mit „keine Veränderung“ ist ein Ergebnis, kein Versäumnis.
Nach unserer Beobachtung ist Schritt 1 der, an dem die meisten Reportings scheitern: Das Prompt-Set wird am Schreibtisch erfunden statt aus echten Kundenfragen abgeleitet. Dann misst man sehr präzise etwas, das niemand fragt.
Wie liest man ein KI-Reporting? Typische Muster entlang der Stufen
Der Nutzen eines stufenweisen Reportings liegt in der Diagnose: Weil jede Stufe die vorherige voraussetzt, zeigt die erste schwache Stufe von unten, wo die Arbeit ansetzt. Die folgenden Muster sind Interpretationshilfen aus unserer Praxis, keine Gesetzmäßigkeiten – sie geben die Richtung vor, nicht die Maßnahme.
Muster 1 – Gute Findability, kaum KI-Impressionen. Die Seiten sind indexiert und ranken, tauchen in den KI-Berichten von Google und Bing aber kaum als Quelle auf. Häufige Ursache: Die Inhalte sind für Menschen lesbar, aber schwer als Wissenseinheit zu verarbeiten – lange Einleitungen, Kernaussagen tief im Text, Begriffe wechseln. Ansatz: Processability (GEO) – Antwort zuerst, klar abgegrenzte Abschnitte, einheitliche Begriffe.
Muster 2 – Hohe Citation Rate, niedrige Mention Rate. Inhalte werden als Beleg herangezogen, die Marke wird im Antworttext aber selten genannt. Das System nutzt das Wissen, verbindet es jedoch nicht mit einem Absender. Ansatz: Trust – Autor und Marke sichtbar machen, Entität konsistent beschreiben, Erwähnungen außerhalb der eigenen Website aufbauen.
Muster 3 – Hohe Mention Rate bei Markenfragen, niedrige bei markenfreien Fragen. Die KI kennt das Unternehmen, wenn man danach fragt, bringt es aber nicht von selbst ins Spiel. Die Marke ist bekannt, aber nicht mit dem Thema verknüpft. Ansatz: thematische Tiefe (Themen-Hubs) und Erwähnungen im Kontext der Kernthemen statt allgemeiner Markenpräsenz.
Muster 4 – Gute Sichtbarkeit, keine messbare Wirkung. Nennungen und Impressionen steigen, Sitzungen im Kanal „AI Assistant“ und Anfragen bleiben flach. Das kann an der Messlücke liegen (Referrer-Verlust, siehe oben) – oder daran, dass die Antwort die Frage bereits vollständig löst und kein Grund zum Klicken bleibt. Ansatz: zuerst Markensuchen und Direct-Einstiege auf Fachseiten prüfen, dann die Frage stellen, ob die zitierten Inhalte einen nächsten Schritt anbieten, den die KI-Antwort nicht ersetzt.
Welches Muster vorliegt, lässt sich nur erkennen, wenn Nennung, Zitat, Empfehlung und Wirkung getrennt erhoben werden. Eine einzelne „KI-Sichtbarkeitsquote“ würde alle vier Fälle gleich aussehen lassen.
Was bedeutet das für Ihr Reporting?
KI-Sichtbarkeit gehört ins bestehende Reporting, nicht in ein separates Dashboard mit eigenen Heldengeschichten. Fünf Konsequenzen:
- Plattformdaten zuerst nutzen. Die KI-Berichte in Google Search Console und Bing Webmaster Tools sind kostenlos, bilden echte Nutzung ab und sollten fester Teil jedes Monatsreportings sein.
- Positionen streichen, Häufigkeiten berichten. Mention Rate, Citation Rate und Recommendation Rate über ausreichend viele Durchläufe ersetzen „Platz in ChatGPT“.
- Nennung, Zitat und Empfehlung getrennt ausweisen. Nur so lässt sich erkennen, ob Inhalte fehlen (AEO) oder das Vertrauen in die Marke (Trust).
- Wirkung als Untergrenze lesen. Der GA4-Kanal „AI Assistant“ zeigt nicht alle KI-Besuche. Steigende Direct-Einstiege auf Fachseiten und Markensuchen gehören mit ins Bild.
- Quartale statt Wochen vergleichen. Die Streuung von KI-Antworten ist groß. Wer wöchentlich reagiert, optimiert auf Rauschen.
Quellen & weiterführende Links
- Reporting & Monitoring – Leistungsseite maxonline
- KI-Sichtbarkeit heute – Knowledge Case maxonline
- Query Memory Effect – Knowledge Case maxonline
- Introducing Search Generative AI performance reports in Search Console – Google Search Central Blog, 2026
- Generative AI performance report (Search) – Google Search Console Help, 2026
- Google Search Console AI performance reports and Search generative AI control rolling out globally – Search Engine Land, 2026
- Introducing AI Performance in Bing Webmaster Tools (Public Preview) – Microsoft Bing Webmaster Blog, 2026
- AI Performance – Bing Webmaster Tools Help – Microsoft, 2026
- Bing Webmaster Tools Adds AI Citation Performance Data – Search Engine Journal, 2026
- Google Analytics Adds AI Assistant As Default Channel Group – Search Engine Journal, 2026
- GA4 adds AI Assistant channel for referral tracking – Semrush, 2026
- Why ChatGPT Traffic Shows as Referral, Organic, and Direct in GA4 – Seresa, 2026
- NEW Research: AIs are highly inconsistent when recommending brands or products – SparkToro, 2026
- AI Recommendations Change With Nearly Every Query: SparkToro – Search Engine Journal, 2026
- Why AI Brand Recommendations Change With Every Query – Passionfruit, 2026
- AI Hotel Rankings Are Not Random: 2026 Consistency Study – Nicolas Sitter, 2026
- Google users are less likely to click on links when an AI summary appears in the results – Pew Research Center, 2025
- Update: AI Overviews Reduce Clicks by 58% – Ahrefs, 2026