Warum ist die Zahl indexierter Seiten keine Erfolgskennzahl?
Eine wachsende Zahl indexierter Seiten sagt nur, dass Google mehr URLs einer Website kennt und gespeichert hat. Ob diese URLs der Website nützen, sagt sie nicht – und Google selbst erwartet gar nicht, dass jede URL im Index landet.
Im Bericht „Seitenindexierung“ der Google Search Console steht es ausdrücklich: Man solle nicht erwarten, dass alle URLs einer Website indexiert werden, sondern nur die kanonischen Seiten. Ziel sei, die kanonische Fassung jeder wichtigen Seite in den Index zu bringen. Nicht indexierte URLs können völlig in Ordnung sein. Außerdem garantiert Google nicht, dass eine Seite gecrawlt, indexiert oder ausgespielt wird – auch dann nicht, wenn sie alle Vorgaben erfüllt.
Trotzdem steht die Zahl der indexierten Seiten in vielen Reportings als Erfolg. Steigt sie, gilt die Website als „größer“. In SEO-Projekten haben wir uns lange daran gewöhnt, diese Kurve zu zeigen, weil sie so schön nach oben geht. Was in ihr steckt, zeigt sie nicht: Produktseiten neben hunderten Filtervarianten, Ratgeber neben leeren Schlagwort-Archiven, Angebote, die vor drei Jahren abgelaufen sind.
Was ist Index Utility?
Index Utility ist der Nutzen, den eine indexierte URL für das Verständnis einer Domain hat. Der Begriff ist ein Denkmodell von maxonline, keine Kennzahl von Google: Er bewertet jede URL danach, ob sie einen eigenen Zweck erfüllt – und ordnet sie einer von vier Klassen zu.
- Tragend: Die URL beantwortet eine eigene Frage oder bedient eine eigene Nachfrage – eine Leistungsseite, ein Ratgeber, eine Produktseite. Sie erklärt, wofür die Domain steht.
- Unterstützend: Die URL hat keine eigene Hauptfrage, macht aber andere Seiten auffindbar und ordnet sie – ein Themen-Hub, eine gepflegte Kategorieseite, eine Übersicht.
- Neutral: Die URL ist nötig, sagt aber nichts über das Thema – Impressum, Datenschutz, Kontakt. Sie zählt nicht gegen die Domain, aber auch nicht für sie.
- Belastend: Die URL wiederholt, was anderswo besser steht, ist leer oder veraltet oder existiert nur als technische Variante – Filter- und Parameter-URLs, Duplikate, Schlagwort-Archive mit einem Beitrag, abgelaufene Angebote ohne Nachfolger.
Im Meusel Visibility Framework gehört Index Utility zur ersten Stufe, SEO (Findability): Sie entscheidet mit, welche Inhalte gefunden und thematisch eingeordnet werden. Die Wirkung reicht aber in die zweite Stufe, GEO (Processability) – also in die Frage, ob KI-Systeme Inhalte als eigenständige Wissenseinheiten verarbeiten können. Eine Domain, deren Index zur Hälfte aus Varianten besteht, ist auch für Maschinen schwerer zu lesen. GEO wird in der Branche teils weiter gefasst; hier steht der Begriff nur für die Verarbeitbarkeit.
Der Index ist keine Ablage. Er ist die Antwort einer Domain auf die Frage, wofür sie steht.
Wann belastet zusätzlicher Index – und wann nicht?
Zusätzlicher Index belastet auf drei Wegen: durch verschwendetes Crawling, durch verteilte Signale und durch ein unschärferes Gesamtbild der Website. Nur der erste Weg hängt von der Größe der Website ab – und genau der wird am häufigsten diskutiert.
Crawling: ein Thema für große Websites
Google beschreibt das Crawl Budget als die Menge an URLs, die Google auf einer Website crawlen kann und will. Der Leitfaden dazu richtet sich ausdrücklich an große Websites: ab etwa 1 Million Seiten mit wöchentlich wechselnden Inhalten oder ab etwa 10.000 Seiten mit täglich wechselnden Inhalten – nach Googles Worten grobe Richtwerte, keine festen Schwellen. Für solche Websites gilt: Doppelte oder unerwünschte URLs kosten Crawling-Zeit, Filternavigationen erzeugen sehr viele URLs, und neue wichtige Seiten werden später entdeckt.
Für eine Website mit 300 Seiten ist das Crawl Budget dagegen kaum ein Thema. Wer Index Utility nur über Crawling begründet, redet kleinen Websites ein Problem ein, das sie nicht haben – und übersieht die beiden anderen Wege.
Signale: verteilt statt gebündelt
Gibt es mehrere URLs mit sehr ähnlichem Inhalt, fasst Google sie zu einer Gruppe zusammen und wählt eine davon als kanonische URL aus, also als die Fassung, die im Index steht. Google nennt als Gründe, eine kanonische URL selbst festzulegen, unter anderem: Signale ähnlicher oder doppelter Seiten zu bündeln und keine Crawling-Zeit auf Duplikate zu verwenden. Wer das Google überlässt, riskiert, dass eine andere Fassung ausgewählt wird als gewünscht – und dass Links und interne Verweise sich auf mehrere Varianten verteilen.
Gesamtbild: die Website als Ganzes
Google bewertet nicht nur einzelne Seiten. In seinen Hinweisen zu Core Updates rät Google bei einem deutlichen Verlust zu prüfen, ob die Website insgesamt – nicht nur einzelne Seiten – hilfreiche, verlässliche Inhalte liefert, und hält fest, dass das Entfernen nicht hilfreicher Inhalte den guten Inhalten helfen kann. Zugleich nennt Google das Löschen ausdrücklich das letzte Mittel, wenn ein Inhalt nicht zu retten ist.
Nach unserer Einschätzung ist dieser dritte Weg für die meisten mittelständischen Websites der wichtigste: Nicht die Zahl der URLs belastet, sondern der Anteil, der nichts zum Thema beiträgt. Einen festen Schwellenwert dafür nennt Google nicht, und wir behaupten auch keinen.
Index und KI-Antworten
Für die KI-Funktionen der Google-Suche ist der Index zugleich der Vorrat an möglichen Belegen. Um in AI Overviews oder im KI-Modus als Link zu erscheinen, muss eine Seite indexiert und mit Snippet anzeigbar sein. Das spricht nicht dafür, möglichst viel zu indexieren – sondern dafür, dass die Seiten mit den besten Antworten zuverlässig im Index stehen. Dass dabei auch Seiten ohne gutes Ranking gewählt werden, zeigt der Blick darauf, warum KI-Systeme auch Seiten zitieren, die bei Google kaum sichtbar sind. Eine Seite mit wenigen Impressionen ist deshalb nicht automatisch belastend.
Wie misst man Index Utility?
Index Utility wird je URL bewertet und für die Website oder einen Bereich als Anteil zusammengefasst: die Index Utility Rate. Sie gibt an, welcher Anteil der indexierten URLs tragend oder unterstützend ist. Die Kennzahl ist ein Messmodell von maxonline; Google kennt sie nicht und nutzt sie nicht.
Die Messung läuft in fünf Schritten:
- Index erfassen. Den Bericht „Seitenindexierung“ der Search Console exportieren und mit einem Crawl der Website und der XML-Sitemap abgleichen. Wichtig sind drei Mengen: indexiert, gecrawlt aber nicht indexiert, und von Google als Duplikat einer anderen URL eingestuft.
- Nachfrage ergänzen. Für jede indexierte URL Impressionen und Klicks der letzten 12 bis 16 Monate aus dem Leistungsbericht der Search Console ergänzen, dazu interne und – wo vorhanden – externe Links.
- Zweck prüfen. Je URL drei Fragen beantworten: Hat sie eine eigene Hauptfrage oder Funktion? Ist sie die eindeutige Fassung dieses Inhalts? Ist sie intern so eingebunden, dass sie erreichbar ist?
- Klassifizieren. Aus den Antworten folgt die Klasse: tragend, unterstützend, neutral oder belastend. Impressionen entscheiden nicht allein, sie zeigen nur, wo genauer hinzusehen ist.
- Rate berechnen. Index Utility Rate = (tragende + unterstützende URLs) ÷ (alle indexierten URLs ohne neutrale) × 100. Neutrale Seiten bleiben außen vor, damit Pflichtseiten das Ergebnis nicht verzerren.
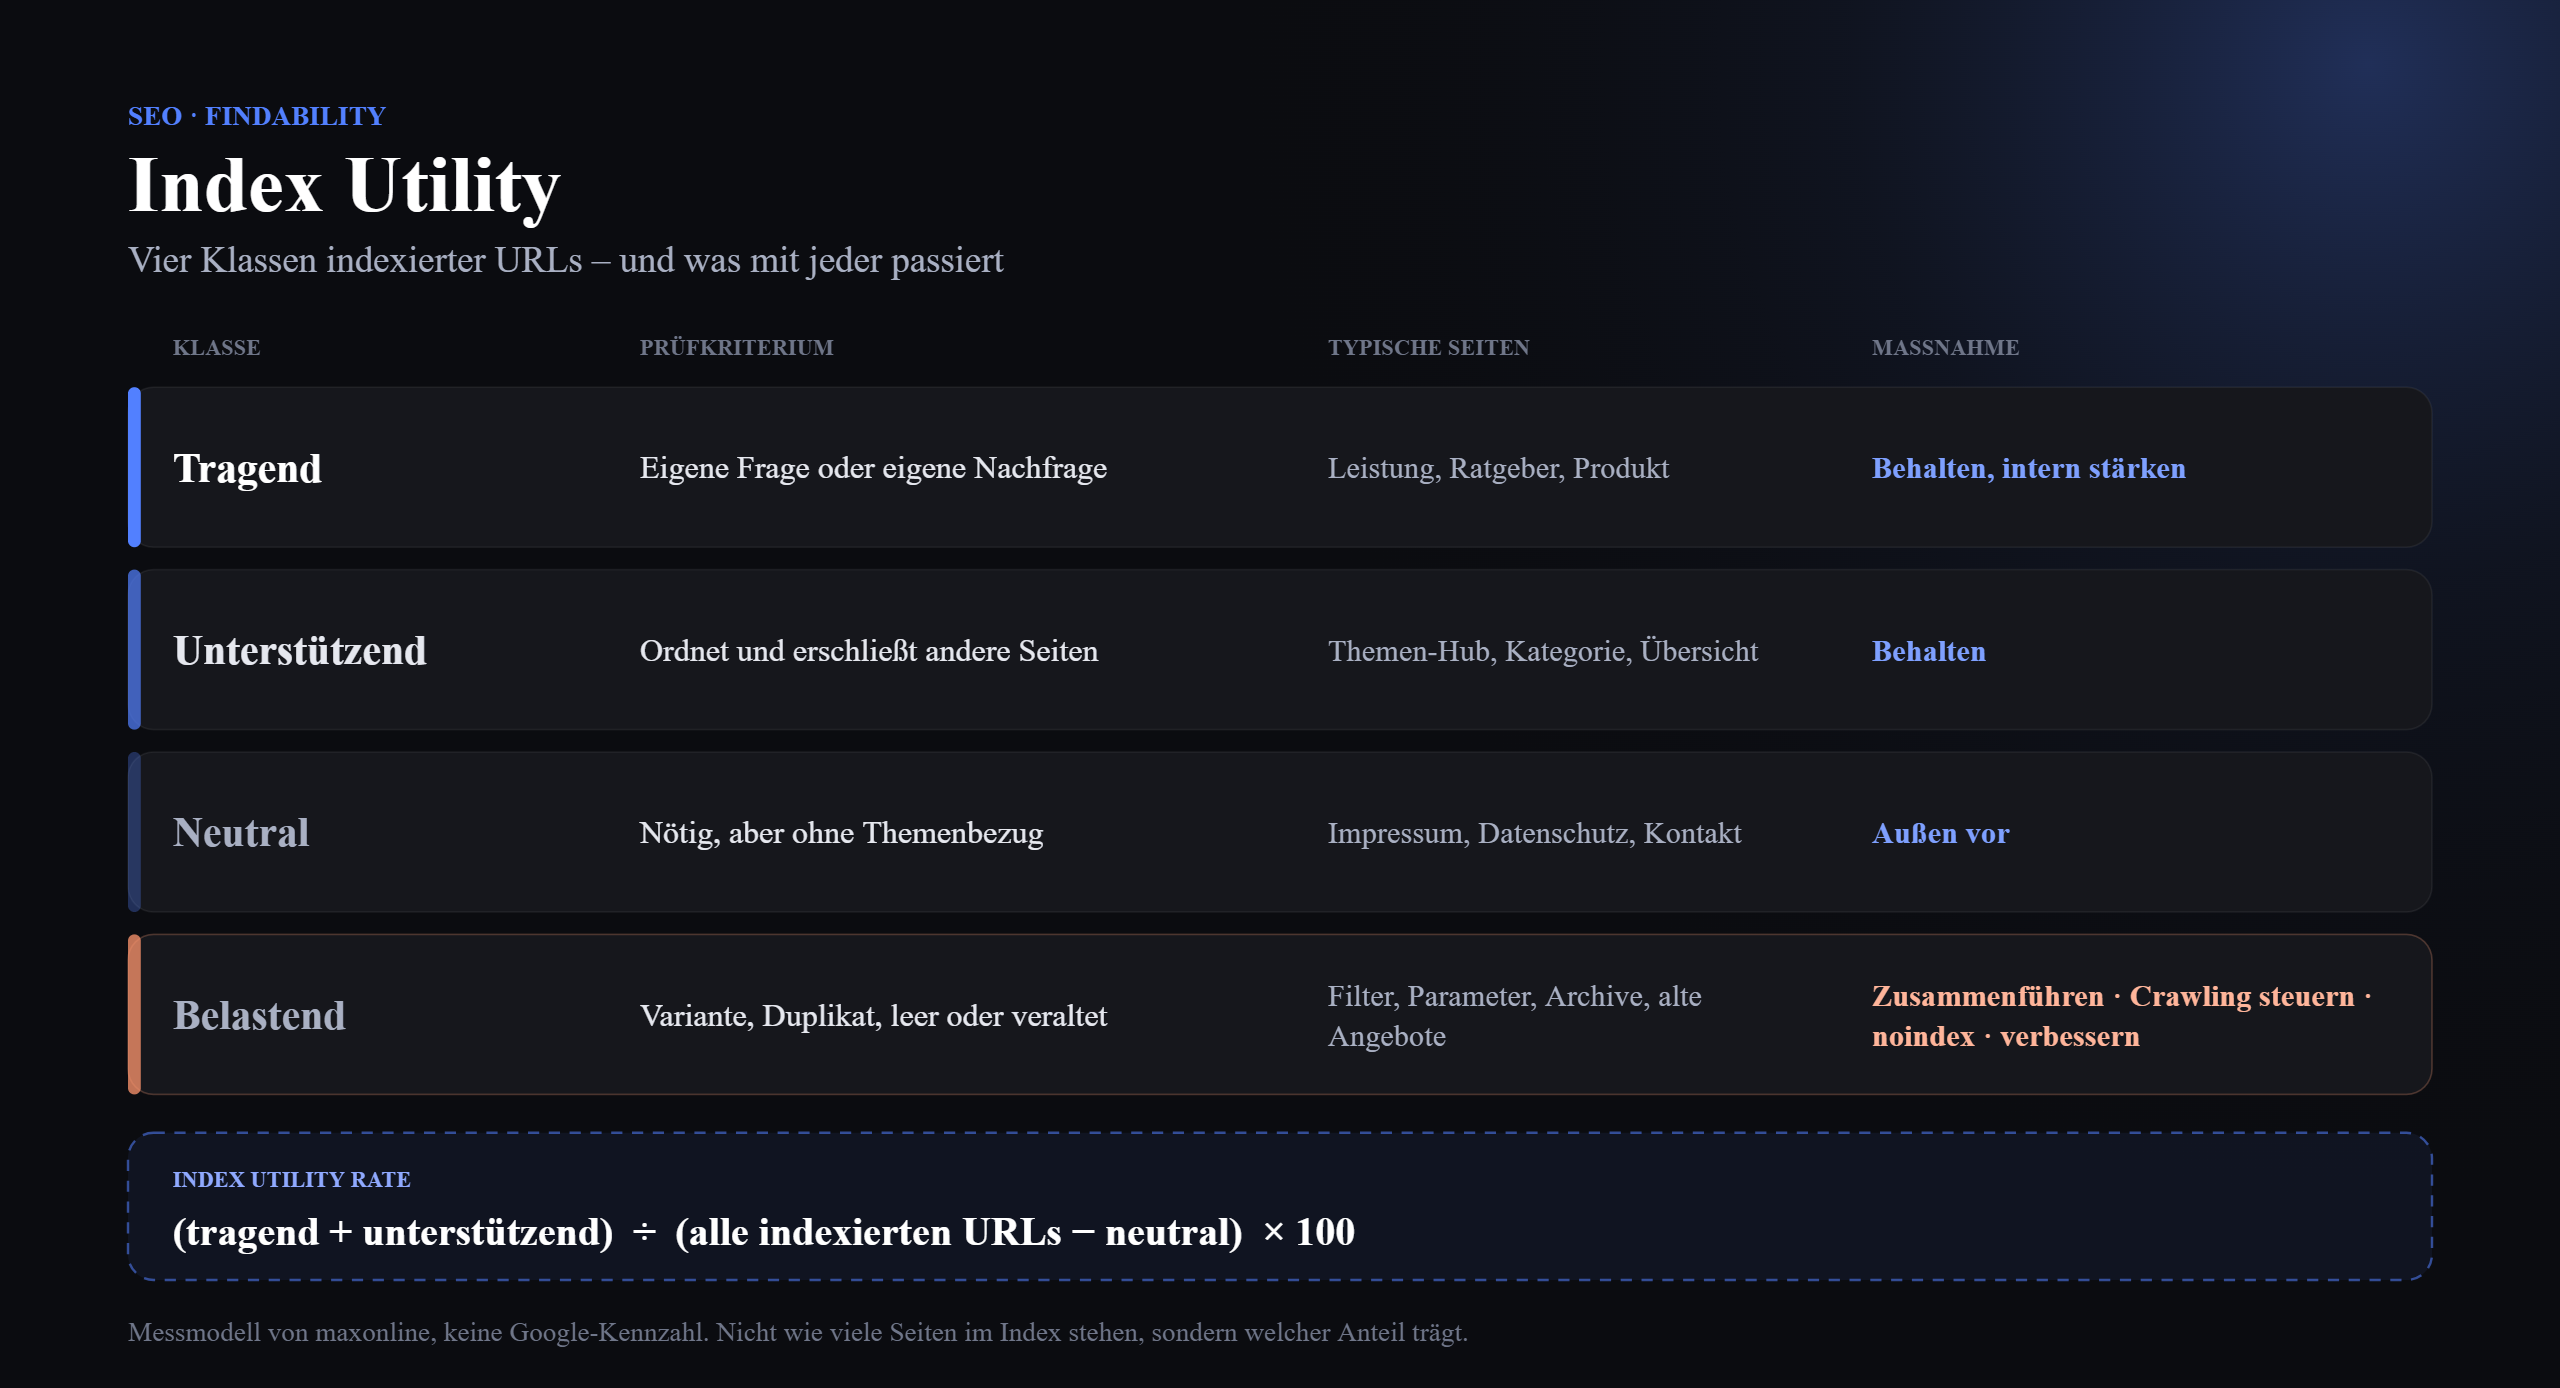
Für belastende URLs gibt es je nach Ursache eine eigene Maßnahme. Duplikate werden über eine kanonische URL oder eine Weiterleitung zusammengeführt. Filter- und Parameter-URLs, die nicht in der Suche erscheinen sollen, werden vom Crawling ausgenommen; Google empfiehlt dafür robots.txt und für leere Filterkombinationen den Statuscode 404. Seiten, die erreichbar bleiben, aber nicht im Index stehen sollen, bekommen ein noindex – das wirkt nur, wenn Google die Seite crawlen darf. Und dünne, aber thematisch richtige Seiten werden verbessert statt entfernt. Welche Seite am Ende was bekommt, ist eine Entscheidung – wie man für jede Seite eine Entscheidung trifft statt nur Befunde zu sammeln, beschreibt das Verfahren der Content Triage.
Praxisbeispiel: Index Utility für ein Hotel
Das folgende Beispiel ist konstruiert und zeigt das Muster, keine gemessenen Werte: Ein Wellnesshotel mit 42 Zimmern betreibt seit zehn Jahren eine Website. Die Search Console meldet 1.240 indexierte Seiten. Die Website soll erklären, wofür das Haus steht: Wellness, Tagungen und Urlaub in der Region.
Auszug aus der Klassifizierung:
| Seitentyp | URLs im Index | Klasse | Maßnahme |
|---|---|---|---|
| Zimmer, Wellness, Tagung, Restaurant | 28 | tragend | behalten, intern stärken |
| Ratgeber „Ausflüge in der Region“ | 46 | tragend | behalten, aktualisieren |
| Themenübersichten | 6 | unterstützend | behalten |
| Impressum, Datenschutz, Kontakt | 5 | neutral | – |
| Pauschalen, seit Jahren abgelaufen | 210 | belastend | zusammenführen auf die aktuelle Angebotsseite |
| Veranstaltungsarchiv 2016–2023 | 380 | belastend | Nützliche Einträge in Ratgeber übernehmen, Rest noindex |
| Buchungsmaske mit Datumsparametern | 520 | belastend | vom Crawling ausnehmen |
| Englische Seiten ohne Übersetzung | 45 | belastend | übersetzen oder zusammenführen |
Befund: Von 1.235 nicht neutralen URLs sind 80 tragend oder unterstützend – eine Index Utility Rate von gut 6 Prozent. Für Google erzählt die Website mehr über alte Termine und Buchungsparameter als über Wellness und Tagungen.
Ergebnis: Nach der Bereinigung sollen rund 120 URLs im Index stehen, davon gut 100 tragend oder unterstützend. Ob sich das in Sichtbarkeit niederschlägt, zeigt erst die Messung danach – sicher ist nur, dass die Domain jetzt eindeutiger beschreibt, was sie anbietet. Welche Übersichtsseiten dabei als Knotenpunkt dienen, lässt sich mit den Prüffragen dazu klären, welche Seiten zum Knotenpunkt ihres Themas werden.
Was Index Utility nicht leistet
Index Utility macht sichtbar, wie viel des Index eine Domain trägt. Bessere Rankings, mehr Traffic oder Zitate in KI-Antworten garantiert eine höhere Rate nicht.
Drei Grenzen sollte jede Auswertung offen nennen:
- Keine Google-Kennzahl. Die Index Utility Rate ist ein Arbeitsmodell, um Befunde vergleichbar zu machen. Es gibt keinen Wert, ab dem Google eine Website besser oder schlechter bewertet.
- Impressionen sind kein Urteil. Eine Seite ohne Impressionen kann tragend sein – etwa ein neuer Ratgeber oder eine Seite, die in KI-Antworten als Beleg dient. Wie sich das belastbar erfassen lässt, zeigt der Knowledge Case dazu, was sich bei KI-Sichtbarkeit belastbar reporten lässt.
- Jede Maßnahme hat Nebenwirkungen. Eine per robots.txt gesperrte Seite kann kein noindex mehr übermitteln. Eine gelöschte Seite verliert ihre Links, wenn sie nicht weitergeleitet wird. Deshalb gehört die Wahl der Maßnahme zu jemandem, der die Technik und das Geschäft kennt.
Was bedeutet das für Ihre Website?
- Indexzahl nicht als Erfolg berichten. Aussagekräftiger ist der Anteil tragender und unterstützender URLs – je Bereich und im Zeitverlauf.
- Die richtige Begründung wählen. Bei kleinen und mittleren Websites geht es selten um Crawl Budget, sondern um Signalverteilung und das Gesamtbild der Domain.
- Zuerst die großen Mengen prüfen. Filter, Parameter, Archive und abgelaufene Angebote erzeugen die meisten belastenden URLs – oft mit einer einzigen Regel lösbar.
- Maßnahme nach Ursache wählen. Zusammenführen, Crawling steuern, noindex oder verbessern – Löschen bleibt das letzte Mittel.
- Regelmäßig messen. Ein technisches SEO-Audit einmal im Jahr zeigt, ob neue Seitentypen den Index wieder aufblähen, bevor es jemand merkt.
Quellen & weiterführende Links
- Content Triage: Für jeden Inhalt eine Entscheidung statt einer Befundliste – maxonline, 2026
- Hub Score: Was hinter dem Begriff steckt – und wie Seiten zum Knotenpunkt ihres Themas werden – maxonline, 2026
- Citation without Ranking: Warum KI-Systeme Quellen zitieren, die bei Google kaum sichtbar sind – maxonline, 2026
- KI-Sichtbarkeit messen: Was sich belastbar reporten lässt – und was nicht – maxonline, 2026
- Page indexing report – Google Search Console-Hilfe, abgerufen 11.10.2026
- Crawl budget management for large sites – Google Search Central, Stand 22.07.2026
- In-depth guide to how Google Search works – Google Search Central, Stand 18.12.2025
- How to specify a canonical URL with rel=“canonical“ and other methods – Google Search Central, Stand 10.07.2026
- Managing crawling of faceted navigation URLs – Google Search Central, Stand 18.12.2025
- Block Search indexing with noindex – Google Search Central, Stand 10.12.2025
- Google Search’s core updates and your website – Google Search Central, Stand 10.12.2025
- AI features and your website – Google Search Central, Stand 10.12.2025