Warum kann eine Website mit jedem neuen Artikel unklarer werden?
Eine Website wird unklarer, wenn neue Inhalte Fragen beantworten, die schon beantwortet sind – und dabei etwas andere Antworten geben. Das passiert selten aus Nachlässigkeit, sondern fast immer aus gutem Willen: Jemand will ein Thema aktualisieren, vertiefen oder für ein neues Keyword sichtbar machen und schreibt dafür einen neuen Beitrag.
Jeder dieser Beiträge ist für sich vertretbar. Zusammen ergeben sie einen Bestand, in dem dieselbe Frage auf fünf Seiten vorkommt: im Ratgeber von 2021, im Update-Artikel von 2023, in der FAQ, auf der Leistungsseite und im Glossar. Keine Seite ist falsch, aber keine ist eindeutig zuständig.
In Content-Projekten sehen wir dieses Muster bei fast jeder Website, die älter als fünf Jahre ist und mehr als einen Autor hatte. Der Redaktionsplan wächst nach Themen und Keywords, die Struktur der Website wächst nicht mit. Ordnung entsteht nicht von selbst, wenn Inhalte dazukommen – sie muss bei jedem neuen Inhalt neu hergestellt werden.
Google formuliert die Grundfrage in seinen Hinweisen zu hilfreichen Inhalten schlicht: Hat die Website einen klaren Hauptzweck oder Schwerpunkt? Im gleichen Katalog steht der Hinweis, dass viel neuer Content allein nicht dafür sorgt, dass eine Website als aktueller gilt.
Was ist Content Entropy?
Content Entropy beschreibt, wie viel Unordnung in den Antworten einer Website steckt: wie viele Seiten dieselbe Frage beantworten, wie stark ihre Aussagen voneinander abweichen und wie unklar ist, welche davon gilt. Der Begriff ist ein Denkmodell von maxonline, keine Kennzahl von Google.
Er lehnt sich an die Informationstheorie an. Claude Shannon führte 1948 Entropie als Maß für Unsicherheit ein: Je mehr gleich wahrscheinliche Möglichkeiten es gibt, desto größer die Unsicherheit. Übertragen heißt das: Je mehr Seiten einer Website als Antwort auf dieselbe Frage in Frage kommen, desto unsicherer ist, welche gemeint ist. Eine Formel übernehmen wir bewusst nicht – die Analogie beschreibt das Prinzip, nicht die Messung.
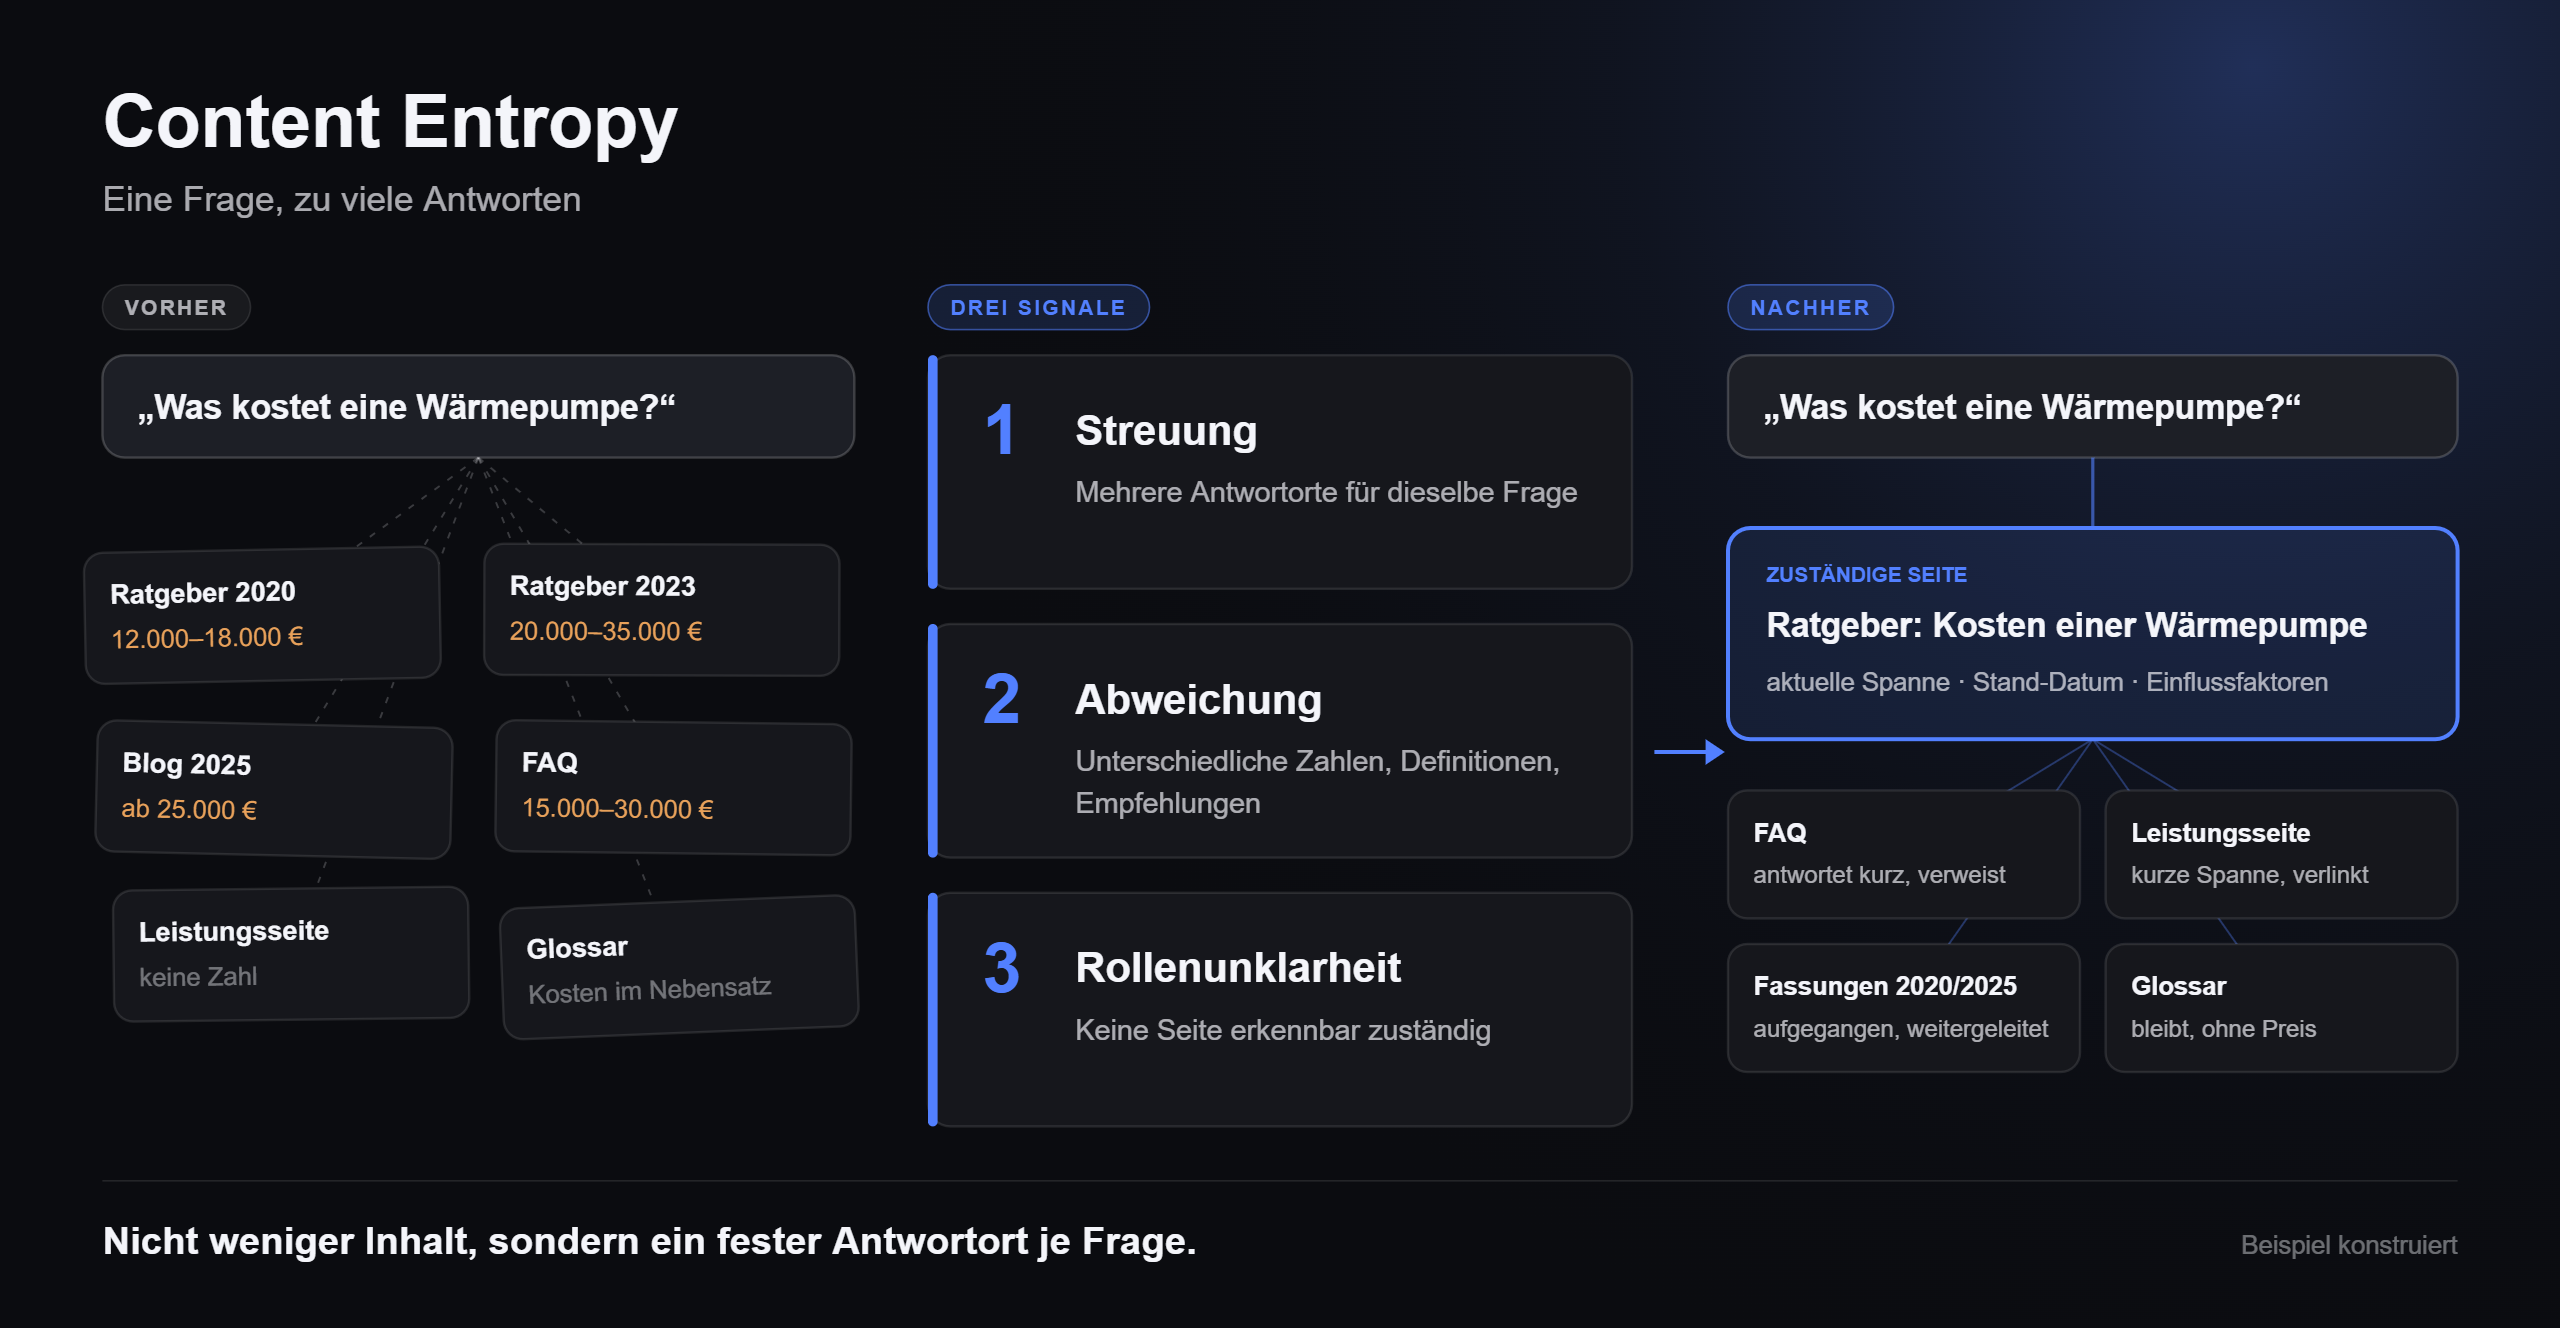
Content Entropy zeigt sich an drei Signalen:
- Streuung: Eine Kernfrage hat mehrere Antwortorte auf derselben Website. Zwei sind oft unproblematisch, ab drei wird es unübersichtlich.
- Abweichung: Die Antwortorte sagen nicht dasselbe – unterschiedliche Zahlen, Definitionen, Empfehlungen oder Stände. Das ist das schärfste Signal, weil es nicht nur unklar, sondern widersprüchlich macht.
- Rollenunklarheit: Keine Seite ist erkennbar zuständig. Interne Links, Titel und Aufbau verteilen sich gleichmäßig auf alle Varianten, statt auf eine Hauptseite zu führen.
Im Meusel Visibility Framework gehört Content Entropy zur ersten Stufe, SEO (Findability): Sie betrifft, wie eine Website thematisch eingeordnet wird. Die Wirkung reicht in GEO (Processability) – ob KI-Systeme Inhalte als eigenständige Wissenseinheiten verarbeiten können – und in AEO (Answerability), also ob eine Website eine Frage direkt und eindeutig beantwortet. GEO wird in der Branche teils weiter gefasst; hier steht der Begriff nur für die Verarbeitbarkeit.
Abgrenzung: Kannibalisierung, Duplikate, Pruning
Content Entropy ist nicht dasselbe wie Keyword-Kannibalisierung. Kannibalisierung beschreibt ein Ranking-Symptom: Mehrere Seiten konkurrieren um dasselbe Keyword. Content Entropy beschreibt den Zustand dahinter – auch dann, wenn gar keine der Seiten rankt oder wenn die Seiten verschiedene Keywords, aber dieselbe Frage bedienen.
Sie ist auch kein Duplicate Content im technischen Sinn. Duplikate sind gleiche Inhalte unter mehreren URLs; Entropie entsteht gerade durch Inhalte, die sich ähneln, aber nicht gleichen. Und sie ist kein Auftrag zum Löschen: Content Pruning ist eine mögliche Folge, nicht das Ziel.
Eine Website wird nicht unklar, weil sie zu viel weiß, sondern weil sie dasselbe an zu vielen Stellen ein bisschen anders sagt.
Wie entsteht Content Entropy?
Content Entropy entsteht aus Routinen, nicht aus Fehlern. Fünf Ursachen begegnen uns am häufigsten:
- Redaktionsplanung nach Keywords statt nach Fragen. Für „Wärmepumpe Kosten“, „Was kostet eine Wärmepumpe“ und „Wärmepumpe Preis“ entstehen drei Artikel, obwohl es eine Frage ist.
- Aktualisieren durch Neuschreiben. Statt den bestehenden Ratgeber zu überarbeiten, erscheint jedes Jahr eine neue Fassung. Die alten bleiben online, verlinkt und indexiert.
- Mehrere Absender. Marketing, Vertrieb, Produktmanagement und Support schreiben über dasselbe Thema – auf der Leistungsseite, im Blog, in der FAQ und im Hilfebereich.
- Varianten für die KI-Suche. Weil KI-Systeme eine Frage per Query Fan-out in viele Teilfragen zerlegen, liegt es nahe, für jede Teilfrage eine eigene Seite zu bauen. Google rät davon ausdrücklich ab: Eigene Inhalte für jede Variante einer Suchanfrage oder jede Fan-out-Anfrage zu erstellen, um Rankings oder KI-Antworten zu beeinflussen, verstößt gegen die Richtlinie gegen massenhaft erstellte Inhalte – und viele Seiten machen eine Website laut Google weder hochwertiger noch relevanter.
- Schnellere Produktion. Mit KI-Werkzeugen ist ein neuer Artikel in einer Stunde fertig. Die Prüfung, ob er etwas Neues sagt und wohin er gehört, dauert so lange wie vorher. Wird sie übersprungen, wächst die Entropie mit der Produktionsgeschwindigkeit.
Was bewirkt Content Entropy bei Suchmaschinen und KI-Systemen?
Content Entropy überlässt die Entscheidung, welche Seite gilt, der Maschine. Bei Suchmaschinen ist das gut belegt, bei KI-Systemen eine begründete Einschätzung.
Suchmaschinen: Google wählt selbst
Google bewertet Seiten einzeln, nutzt aber auch website-weite Signale. Ähnliche Ergebnisse werden aussortiert: Googles Deduplizierungssysteme zeigen bei sehr ähnlichen Seiten nur die relevantesten, und in den Top-Ergebnissen erscheinen in der Regel höchstens zwei Treffer derselben Website. Bei sehr ähnlichen URLs wählt Google eine Fassung als kanonische URL aus; Google nennt als Grund, das selbst festzulegen, unter anderem die Bündelung von Signalen.
Wer fünf Antwortorte anbietet, bekommt also nicht fünf Chancen, sondern eine Auswahl, die Google trifft – oft nicht die, die man gewählt hätte. Links, interne Verweise und Nutzersignale verteilen sich auf mehrere Seiten, statt eine zu stärken.
Ehrlich ist auch die Gegenrichtung: Mehrere Seiten, die für dieselbe Suchanfrage ranken, sind laut Google kein Problem an sich. Ahrefs spricht von echter Kannibalisierung nur dann, wenn die Seiten dieselbe Suchabsicht bedienen und die organische Leistung darunter leidet. Content Entropy ist deshalb kein Ranking-Gesetz, sondern ein Klarheitsproblem – das sich in Rankings zeigen kann, aber nicht muss.
KI-Systeme: mehrere Belege, eine Antwort
Googles KI-Funktionen stützen sich auf den Suchindex und die Ranking-Systeme; Google empfiehlt in diesem Zusammenhang ausdrücklich, doppelte Inhalte zu reduzieren. Nach unserer Einschätzung verschärft die KI-Suche das Problem: Ein KI-System sucht für eine Antwort einzelne Passagen. Findet es auf derselben Website drei Passagen mit drei verschiedenen Zahlen, muss es eine wählen, mischen oder eine andere Quelle nehmen. Einen reproduzierbaren Mechanismus dafür haben wir nicht belegt – plausibel ist aber, dass eine eindeutige Antwort leichter zu verarbeiten ist als drei ähnliche.
Für Leser ist der Effekt am direktesten: Wer auf zwei Seiten zwei Preisspannen findet, glaubt keiner von beiden ganz. Trust entscheidet am Ende – aufgebaut wird er auf jeder Ebene, auch durch Widerspruchsfreiheit.
Wie misst man Content Entropy?
Content Entropy wird nicht als Score gemessen, sondern je Kernfrage als Lückenliste sichtbar gemacht: in einer Content Redundancy Map. Sie zeigt für jede Frage, welche Seiten sie beantworten, mit welcher Aussage – und welche Seite zuständig sein soll.
Die Map entsteht in fünf Schritten:
- Kernfragen sammeln. Für einen Themenbereich die 10 bis 30 Fragen festhalten, die die Website beantworten soll – aus Search Console, Vertrieb, Support und den Teilfragen der Zielgruppe. Fragen, nicht Keywords.
- Antwortorte zuordnen. Für jede Frage alle Seiten notieren, die sie ganz oder in einem Abschnitt beantworten. Hilfen: Website-Suche,
site:-Abfragen, Search Console (Suchanfrage → Seiten), ein Crawl mit Überschriften. - Aussagen vergleichen. Je Antwortort die Kernaussage in einem Satz festhalten – Zahl, Definition, Empfehlung, Stand. Abweichungen markieren.
- Rollen prüfen. Gibt es eine Seite, auf die Titel, interne Links und Navigation erkennbar zeigen? Wenn nicht: Rollenunklarheit.
- Zuständige Seite festlegen. Für jede Frage eine Hauptseite bestimmen. Alle anderen Antwortorte bekommen eine Rolle: verweisen, vertiefen oder in der Hauptseite aufgehen.
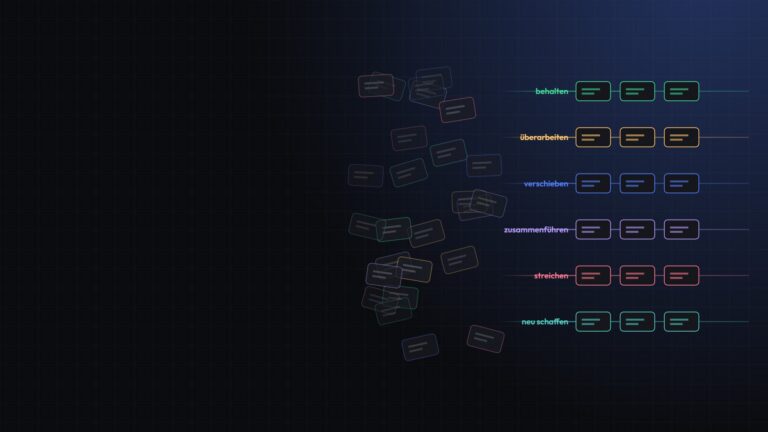
Was danach mit jedem einzelnen Inhalt passiert, ist eine eigene Entscheidung – wie aus jedem Befund eine von sechs Entscheidungen wird, beschreibt das Verfahren der Content Triage. Die Redundancy Map liefert dafür die Diagnose, die Triage die Entscheidung.
Zwei Grenzen gehören zu jeder Auswertung. Erstens gibt es keinen Schwellenwert, ab dem Google eine Website schlechter bewertet; die Map macht Unordnung sichtbar, sie misst kein Ranking-Risiko. Zweitens ist Zusammenführen kein Schnellweg: Google hat schon 2018 erklärt, dass Zusammenlegungen und Aufteilungen länger brauchen, bis sie sich im Index einspielen, als ein einfacher Umzug. Wer zusammenführt, sollte mit Wochen bis Monaten rechnen, nicht mit Tagen.
Praxisbeispiel: Content Entropy bei einem Wärmepumpen-Fachbetrieb
Das folgende Beispiel ist konstruiert und zeigt das Muster, keine gemessenen Werte: Ein regionaler Fachbetrieb für Heizungstechnik betreibt seit 2019 einen Ratgeberbereich mit 140 Beiträgen von vier Autoren. Eine der Kernfragen lautet: „Was kostet eine Wärmepumpe mit Einbau?“
Auszug aus der Content Redundancy Map:
| Antwortort | Erschienen | Kernaussage | Rolle heute |
|---|---|---|---|
| Ratgeber „Wärmepumpe Kosten“ | 2020 | 12.000–18.000 € | rankt schwach, viele Links |
| Ratgeber „Was kostet eine Wärmepumpe 2023?“ | 2023 | 20.000–35.000 € | rankt am besten |
| Blog „Wärmepumpe Preis: Update“ | 2025 | „ab 25.000 €“ | kaum Impressionen |
| FAQ-Seite | 2021 | „je nach Haus 15.000–30.000 €“ | eigener Abschnitt |
| Leistungsseite Wärmepumpe | 2022 | keine Zahl, Verweis auf Beratung | wichtigste Seite fürs Geschäft |
| Glossar „Jahresarbeitszahl“ | 2022 | Kosten im Nebensatz | nebenbei |
Befund: Sechs Antwortorte (Streuung), vier verschiedene Preisaussagen (Abweichung), und die Seite, auf die Navigation und Kampagnen zeigen, beantwortet die Frage gar nicht (Rollenunklarheit). Jeder Beitrag war zu seinem Zeitpunkt richtig. Zusammen sagen sie: Wir wissen es nicht genau.
Entscheidung: Der Ratgeber von 2023 wird zur zuständigen Seite, mit aktueller Preisspanne, Stand-Datum und den Einflussfaktoren. Die Fassungen von 2020 und 2025 gehen darin auf und leiten weiter. Die FAQ beantwortet die Frage in zwei Sätzen und verweist auf den Ratgeber. Die Leistungsseite übernimmt eine kurze Spanne und verlinkt den Ratgeber als Vertiefung. Das Glossar bleibt, ohne Preisangabe. Welche Seite dabei als Knotenpunkt des ganzen Themas dient, lässt sich mit den Prüffragen, an denen sich eine Hub-Seite messen lässt, entscheiden.
Ergebnis: Statt sechs Antworten gibt es eine Antwort und vier Verweise. Ob sich das in Rankings oder KI-Zitaten zeigt, beweist erst die Messung danach. Sicher ist: Die Website sagt jetzt an jeder Stelle dasselbe.
Was bedeutet das für Ihre Website?
- Vor jedem neuen Beitrag fragen, wo die Antwort schon steht. Ein Content-Audit vor der Redaktionsplanung kostet weniger als das Aufräumen danach.
- Aktualisieren statt neu schreiben. Eine gepflegte Seite mit Stand-Datum ist eindeutiger als drei Jahresfassungen.
- Jeder Kernfrage eine zuständige Seite geben. In der Content-Strategie gehört zu jeder Frage ein fester Antwortort; ein Themen-Hub ordnet die Teilfragen, statt sie zu vervielfachen – wie ein Themen-Hub die Teilfragen der KI-Suche auf feste Antwortorte verteilt, zeigt der Knowledge Case dazu.
- Abweichungen zuerst beheben. Widersprüchliche Zahlen und Definitionen schaden mehr als bloße Wiederholung – sie sind das erste, was in einer Redundancy Map auffällt.
- Entropie und Index getrennt betrachten. Ob eine URL überhaupt einen Zweck hat, klärt der Blick darauf, welche indexierten URLs eine Domain tatsächlich tragen; Content Entropy fragt, ob mehrere nützliche URLs dasselbe sagen.
Quellen & weiterführende Links
- Content Triage: Für jeden Inhalt eine Entscheidung statt einer Befundliste – maxonline, 2026
- Index Utility: Welche indexierten URLs eine Domain stärken – und wann zusätzlicher Index belastet – maxonline, 2026
- Hub Score: Was hinter dem Begriff steckt – und wie Seiten zum Knotenpunkt ihres Themas werden – maxonline, 2026
- Themen-Hubs in der KI-Suche: Wie Hub-Seiten die Teilfragen von Query Fan-out abdecken – maxonline, 2026
- A guide to Google Search ranking systems – Google Search Central, Stand 10.12.2025
- Optimizing your website for generative AI features on Google Search – Google Search Central, Stand 10.07.2026
- Creating helpful, reliable, people-first content – Google Search Central, Stand 05.10.2026
- How to specify a canonical URL with rel=“canonical“ and other methods – Google Search Central, Stand 10.07.2026
- Google Search’s core updates and your website – Google Search Central, Stand 10.12.2025
- Google Answers SEO Question About Keyword Cannibalization – Search Engine Journal (Roger Montti), 22.09.2025
- Keyword Cannibalization: What It (Really) Is & How to Fix It – Ahrefs, abgerufen 20.10.2026
- Google: Site Splits Or Merges Take Longer Than Site Moves – Search Engine Roundtable, 17.01.2018
- A Mathematical Theory of Communication – Claude E. Shannon, Bell System Technical Journal, 1948